

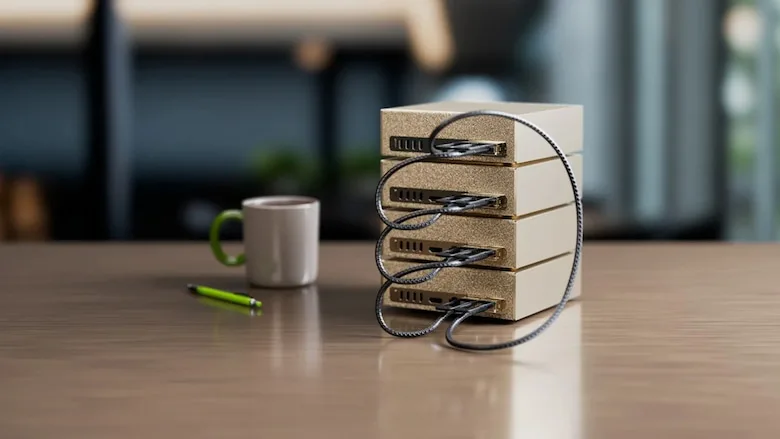
A NVIDIA revelou durante a conferência Supercomputing 2026 (SC26), em Chicago, o DGX Spark HPC Developer Kit — um supercomputador de mesa compacto formado por quatro mini-PCs que dispensam a estrutura tradicional de racks de servidores. Com impressionantes 512 GB de memória unificada e 16 TB de armazenamento NVMe, o conjunto permite rodar localmente modelos de inteligência artificial de até 700 bilhões de parâmetros diretamente na estação de trabalho de pesquisadores e desenvolvedores.
Mais do que impressionar pelos números brutos, a proposta da fabricante é democratizar a computação científica de alto desempenho (HPC), eliminando a necessidade de alugar horas caríssimas em nuvem ou enfrentar longas filas para acessar grandes clusters corporativos e universitários.
Arquitetura Grace Blackwell e conexão em anel sem switch
O kit é composto por quatro unidades idênticas baseadas no superchip NVIDIA GB10 Grace Blackwell. Cada módulo individual traz um processador Arm de 20 núcleos integrado a uma GPU da arquitetura Blackwell (com 6.144 núcleos CUDA e núcleos Tensor de quinta geração) e 128 GB de memória LPDDR5X coerente — compartilhada entre CPU e GPU com largura de banda de 273 GB/s, entregando até 1 petaflop em computação FP4.
Quando interligados, os quatro dispositivos somam um poder de fogo inédito para o formato desktop:
- Processamento: 80 núcleos de CPU Arm;
- Aceleração gráfica: 24.576 núcleos CUDA;
- Memória total: 512 GB de RAM/VRAM unificada LPDDR5X;
- Armazenamento: 16 TB em unidades SSD NVMe de alta velocidade;
- Interconexão: Comunicação direta via NVIDIA ConnectX-7.
Um dos grandes destaques de engenharia está na topologia de rede: os quatro mini-PCs são conectados diretamente entre si em formato de anel (cada máquina se liga às duas vizinhas). Essa arquitetura elimina a necessidade de comprar e configurar um switch de rede externo no kit padrão de quatro nós.
Vale destacar, porém, que o sistema não se comporta automaticamente como uma única placa de vídeo gigante de 512 GB. Para extrair todo o potencial do conjunto, é obrigatório utilizar softwares preparados para distribuir os pesos e os cálculos entre os quatro nós.
Modelos de IA com até 700 bilhões de parâmetros fora da nuvem
Na frente de inteligência artificial, o DGX Spark HPC permite implantar e executar localmente grandes modelos de linguagem (LLMs) de até 700 bilhões de parâmetros — como o DeepSeek V4.1 — utilizando o formato de quantização NVFP4, que reduz a pegada de memória sem comprometer drasticamente a precisão das respostas.
A NVIDIA reforça que o foco do cluster compacto está na inferência e execução local, e não no treinamento massivo do zero. Ainda assim, para laboratórios de pesquisa, hospitais e empresas que lidam com dados sigilosos que não podem trafegar em servidores de terceiros, ter essa capacidade dentro do próprio escritório representa uma mudança de paradigma.
Computação científica e casos reais em universidades
Embora a IA roube os holofotes, o kit foi desenhado como uma plataforma completa de desenvolvimento para HPC (High-Performance Computing), acompanhado pelo pacote NVIDIA HPC SDK (com compiladores C, C++ e Fortran acelerados por GPU e bibliotecas MPI). Na prática, cientistas podem programar, depurar e validar simulações localmente antes de enviá-las a supercomputadores gigantescos, abrangendo áreas como:
- Dinâmica molecular e bioquímica: NAMD, GROMACS, OpenFold3 e Boltz-2;
- Ciência de materiais: LAMMPS e Kokkos;
- Aerodinâmica e fluidos: OpenFOAM;
- Meteorologia e clima: WRF.
O impacto prático já aparece em instituições de ponta. Na Universidade da Califórnia em Berkeley, o laboratório Rubin Lab utilizou o DGX Spark com o modelo genômico Evo 2 para analisar sequências bacterianas e obteve resultados finais 15 vezes mais rápido no tempo total de entrega — simplesmente por evitar a fila de espera de 11 horas do supercomputador central da universidade.
Escalonamento gradual: vale começar com quatro unidades?
Para a maioria das equipes de desenvolvimento, a recomendação técnica é iniciar com uma única unidade do DGX Spark (128 GB de memória), que já dá conta de rodar localmente modelos de até 200 bilhões de parâmetros e realizar ajustes finos (LoRA/retreinamento) em modelos de até 70 bilhões.
| Configuração | Superchips | Núcleos Arm | Memória Unificada | Indicação de Uso |
|---|---|---|---|---|
| 1× DGX Spark | 1× NVIDIA GB10 | 20 núcleos | 128 GB | Prototipagem de IA, agentes locais e fine-tuning até 70B |
| 2× DGX Spark | 2× NVIDIA GB10 | 40 núcleos | 256 GB | Modelos intermediários e simulações científicas locais |
| 4× DGX Spark (Kit HPC) | 4× NVIDIA GB10 | 80 núcleos | 512 GB | Inferência até 700B (NVFP4) e clusters de laboratório sem switch |
À medida que os projetos crescem, novos nós podem ser adicionados (chegando inclusive a arranjos maiores com switches dedicados). Contudo, é importante lembrar que o ganho de performance não escala de forma perfeitamente linear devido à latência de comunicação entre os nós — e que, para treinamentos pesados em escala industrial, os servidores tradicionais em rack continuam insubstituíveis.
Fonte: cenariomt